
Heutzutage gilt kein neues elektronisches Gerät mehr als „Hightech“, wenn es nicht über eine Form von angeblicher „künstlicher Intelligenz“ oder KI verfügt. Die wirklich anspruchsvollen Anwendungen erfordern eine enorme Rechenleistung – kann man mit einem einfachen Mikrocontroller überhaupt etwas erreichen? Ich beginne zunächst mit einigen Grundlagen.
Was ist KI?
Ein Hauptproblem bei dem Versuch, künstliche Intelligenz zu erklären oder zu diskutieren, ist, dass jeder, ob Laie oder Wissenschaftler/Ingenieur, eine feste Meinung zu diesem Thema hat. Das liegt daran, dass es keine einheitliche Definition mit Grenzen bzw. Abgrenzungen gibt. Ein Laie wird sich also vorstellen, dass die derzeitige Technologie nur noch einen kleinen Schritt davon entfernt ist, uns Maschinen zu bescheren, die wirklich denken, uns die Arbeit wegnehmen, sich selbst reproduzieren können und uns, ihre Erbauer, schließlich als weitaus minderwertige Wesen betrachten, was unweigerlich schlimme Folgen hat. Diese dystopische Vision könnte eintreten, aber sie beruht auf einer wichtigen Eigenschaft des menschlichen Gehirns, die die derzeitige KI nicht besitzt: Vorstellungskraft. Fragt man einen Wissenschaftler oder Mathematiker, der sich mit künstlicher Intelligenz befasst, nach deren Fähigkeiten, wird man mit unverständlichem Jargon überschüttet und ist am Ende zwar nicht schlauer, aber überzeugt, dass sie wirklich fortschrittlich sein muss, weil man kein Wort verstanden hat. Fragt man einen Ingenieur, wird die Antwort wahrscheinlich unhöflich ausfallen, denn der Chef seines Chefs hat in einem Management-Magazin alles über KI gelesen und möchte, dass sie in alle künftigen Produkte integriert wird. Außerdem besteht das Marketing darauf, dass alte Bezeichnungen wie „Smart“ oder „Intelligent“ durch „Powered by AI“ ersetzt werden müssen, da sonst die Verkaufszahlen in den Keller gehen. Zu zynisch? Glauben Sie es nicht.
Wie weit sind wir also mit einer Definition? Aus technischer Sicht dreht sich das derzeitige Konzept der KI um einen sehr leistungsfähigen Algorithmus zur Mustererkennung, der auf einer künstlichen Version des neuronalen Netzes des menschlichen Gehirns basiert. Das Artifical Neural Network (künstliches neuronale Netz, ANN) wird in der Regel als Simulation auf einem herkömmlichen Multi-Core-Computer ausgeführt. Letztendlich soll das ANN in Hardware realisiert werden, und zwar mit einem Netz künstlicher Neuronen, die mithilfe der vom Gehirn verwendeten Methode der zeitlich abgestimmten elektrischen Impulse bzw. „Spikes“ miteinander kommunizieren. Daher auch der Begriff Spiking Neural Network (SNN). Bei der Erstellung eines funktionierenden neuronalen Netzes gibt es drei Hauptaufgaben: Entwurf eines für die Anwendung geeigneten Netzmodells, Training des Netzes und schließlich Inferenz oder Ableitung von Ergebnissen aus dem Netzmodell.
Das Modell
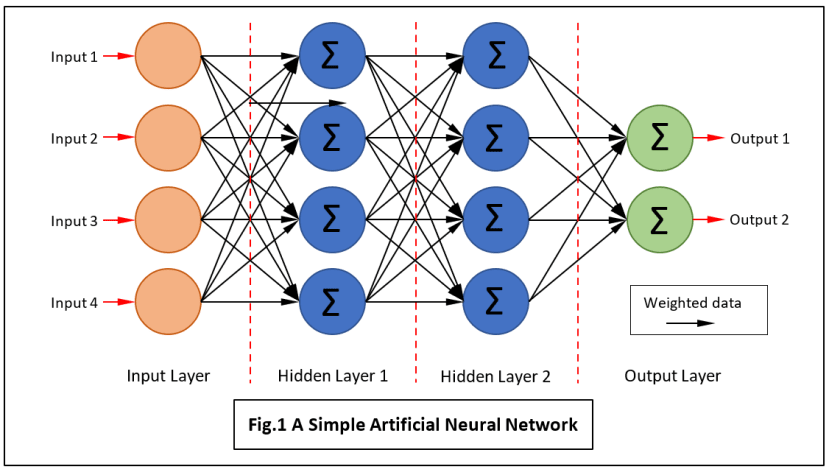
Eine besondere Form von ANN ist als Convolutional Neural Network (CNN) bekannt. Dieses besteht aus einer Reihe von miteinander verbundenen Perceptrons (Abb. 1), die auf digitaler Standardtechnologie basieren. Dieses einfache Beispiel hat eine Schicht mit vier Eingängen, zwei Zwischenschichten und eine Schicht mit zwei Ausgängen. Wie entscheiden Sie bei einem neuen Design über die Anzahl der Eingänge und Ausgänge und vor allem über die Anzahl der versteckten Schichten?
Das ist MegaML, was ist mit TinyML?
Ich habe die obigen Zahlen angeführt, um deutlich zu machen, dass die natürliche Intelligenz selbst der hochentwickeltsten Maschine auf dem Planeten in jeder Hinsicht weit überlegen ist. Trotz des enormen Stromverbrauchs von Computern ist es gut möglich, dass Bildverarbeitungssysteme, die nur auf CNNs mit Videoeingabe basieren, nie genau genug für autonome Fahrzeuge sein werden. Was um alles in der Welt kann man also mit einem einzigen mikroprozessorbasierten SBC machen? Eigentlich eine ganze Menge – nur nicht zu ehrgeizig werden. TinyML sorgt für viel Aufregung in der IoT-Welt (Internet der Dinge). Das Konzept, Millionen von Haushaltsgeräten und anderen Datenquellen über das Internet mit der „Cloud“ zu verbinden, schien damals eine großartige Idee zu sein. Die Daten könnten von diesen Geräten erfasst, von Cloud-Servern verarbeitet und Ergebnisse oder Steuersignale zurückgesendet werden. Leider hat der schiere Umfang der Verarbeitung, ganz zu schweigen von den Sicherheitsproblemen, die z. B. bei medizinischen und Fitness-Monitoren auftreten können, der Sache eher einen Dämpfer verpasst. Bis jemand auf die Idee kam, einen Teil der Datenverarbeitung lokal durchzuführen, bevor sie an die Cloud gesendet wird – die so genannte Edge-Verarbeitung.
Ein Beispiel für „AI at the Edge“ (KI im Edge Computing)
Die automatisierten Fabriken, die die Grundlage der Industrie 4.0 bilden, werden voller Maschinen sein, die mit höchster Effizienz laufen müssen. Da es keine menschlichen Bediener geben wird, die Anzeichen eines drohenden Ausfalls erkennen könnten, müssen die Maschinen von Computern mit elektronischen Sensoren überwacht werden. Es ist unwahrscheinlich, dass ein einzelner Sensor oder auch nur ein Sensortyp in der Lage ist, einen Fehlerzustand zuverlässig anzuzeigen. So kann ein Elektromotor, der kurz vor einem Lagerschaden steht, hochfrequente Geräusche bei bestimmten Frequenzen aussenden, die mit der Drehung der Welle zusammenhängen. Dies könnte zu niederfrequenten Schwingungen führen, die mit einem Anstieg des Ankerstroms, einem Rückgang der Drehzahl und einem Anstieg der Gehäusetemperatur einhergehen. All diese Veränderungen können anfänglich sehr klein sein und von einem menschlichen Beobachter unbemerkt bleiben, bis es zu spät für Abhilfemaßnahmen ist, wie z. B. das Auftragen einer Ölkanne! Der Überwachungscomputer verarbeitet die Signale von Beschleunigungs- und Thermosensoren, die an den Lagergehäusen angebracht sind, von Umgebungstemperatursensoren und Mikrofonen und nutzt die vorhandenen Daten von Wellentachometern und Stromsensoren der Stromversorgung. Die herkömmliche Computerprogrammierung, die auf einer WENN-DANN-SONST-Struktur basiert, könnte verwendet werden, um aus all den Daten einen Sinn zu machen, aber KI bietet eine Alternative, bei der echte Daten von echten Maschinen verwendet werden, um ein CNN zu trainieren. Der Vorteil des Einsatzes von KI unter diesen Umständen besteht darin, dass das Netz bei einem vollständigen Satz von Trainingsdaten nicht nur alle bekannten Eingabemuster erkennen sollte, die zu Fehlern führen, sondern auch neue, subtilere Muster ausfindig machen kann, die bei einer menschlichen Überprüfung übersehen werden. Ein Blick auf das Muster der erzeugten Gewichte könnte überflüssige Eingaben aufzeigen, die wenig oder nichts zur Analyse beitragen. Wenn die verwendeten Eingaben zu falsch positiven oder negativen Ergebnissen führen, kann dies ein Hinweis darauf sein, dass ein zusätzlicher Sensor erforderlich ist.
TinyML ist das, was der Name schon sagt: Es ist für relativ kleine Anwendungen mit wenigen Eingaben/Ausgaben und einer geringen Anzahl von zu erkennenden Objekten/Bedingungen konzipiert. Das macht sie ideal, um eingebettete „Dinge“ intelligenter zu machen und die Belastung der Kommunikationsverbindungen und Server im Internet zu verringern.
Die Hardware
Ich habe bereits gezeigt, dass die Erkennung/Klassifizierung von Objekten in Echtzeit-Videos die Leistung eines Supercomputers erfordert. Weniger ehrgeizige Projekte können auf einigen der leistungsfähigen, aber preiswerten SBCs und ARM Cortex-M Mikrocontroller-Boards auf dem Markt ausgeführt werden. Die Erkennung von Objekten in Bildern mit niedriger Auflösung ist mit dem Raspberry Pi 4 (182-2096) , BeagleBone AI, Sony SPRESENSE (178-3376) , Arduino Nano 33 Sense (192-7592) und sogar dem Raspberry Pi Pico (212-2162) möglich. Die ersten beiden sind relative Verarbeitungsschwergewichte, auf denen Versionen des Linux-Betriebssystems laufen. Die beiden anderen sind weniger leistungsfähige Mikrocontroller-Platinen, verfügen aber über viele eingebaute Sensoren. Sehr einfache KI kann auch auf 32-Bit-Mikrocontrollern ohne FPU und mit mindestens 16 KB Speicher ausgeführt werden – Raspberry Pi Pico fällt in diese Kategorie. Bei der Arbeit mit stromsparenden Prozessoren können beispielsweise Maßnahmen ergriffen werden, um den Prozess zu beschleunigen:
- Verwenden Sie 8-Bit-Integer-Zahlen anstelle von 32-Bit-Gleitkommazahlen. Dieser Auflösungsverlust beeinträchtigt die Erkennungsgenauigkeit bei sehr großen Netzen wie dem Kfz-Vision-System erheblich. Aber 8-Bit-Zahlen sind für Anwendungen, die auf einem Mikrocontroller implementiert werden können, mehr als ausreichend.
- Pooling-Schichten können eingefügt werden, um die Anzahl der Knoten in den nachfolgenden Schichten zu verringern. Diese Technik wird häufig bei Bilddaten verwendet, bei denen die für die Erkennung erforderlichen Merkmale stark ausgeprägt sind und bei denen eine Verringerung der Auflösung dazu führt, dass sie zwar „blockiger“, aber immer noch durch nachfolgende kleinere Ebenen erkennbar sind.
- Bei der Verarbeitung eines RGB-Farbbildes (d. h. drei Eingänge) kann die Erkennung tatsächlich verbessert werden, wenn nur ein Farbkanal verwendet wird.
Training des Modells
Die derzeit dominierende KI-Entwicklungsumgebung ist TensorFlow von Google. Ursprünglich für Anwendungen gedacht, die Supercomputer benötigen, gibt es jetzt eine abgespeckte Version für bescheidenere Systeme namens Tensorflow Lite. Eine noch kleinere Version ist jetzt für Mikrocontroller mit oder ohne FPU und mindestens 16 KB Speicher verfügbar. Es überrascht nicht, dass es TensorFlow Lite für Mikrocontroller heißt. Ein CNN so zu trainieren, dass es irgendwie funktioniert, ist einfach; es so zu trainieren, dass es in Situationen, in denen es um Leben und Tod geht, keine Fehler macht, ist sehr, sehr viel schwieriger. So schwer, dass kein derzeit entwickeltes System zur Objekterkennung für fahrerlose Autos auch nur annähernd ein akzeptables Vertrauensniveau erreicht. Eine Reihe von tödlichen Unfällen in den letzten Jahren, die durch eine falsche Interpretation von visuellen Daten verursacht wurden, zeugt davon. Glücklicherweise sind TinyML-Netze, da sie klein sind, viel einfacher zu trainieren. Das Training für große Netze wird in der Regel mit Cloud-basierten Tools durchgeführt, da hierfür sehr leistungsstarke Computer erforderlich sind. Für TinyML werden einige Tools jedoch auf einem lokalen PC ausgeführt. Der Prozess der Ausbildung ist täuschend einfach. Für die Anwendung Maschinendiagnose also:
- Sammeln Sie eine große Anzahl von Sensordatensätzen, wobei jeder mit einer Kennzeichnung versehen ist, die angibt, ob die Daten von einem Rechner stammen, von dem bekannt ist, dass er ausfällt, oder von einem, der normal läuft. Verfügt das Netz über mehrere Ausgänge zur Meldung verschiedener Fehlerarten, müssen alle entsprechenden Eingabedatensätze entsprechend gekennzeichnet werden. Es ist sehr wichtig, viele Beispiele für jede zu erkennende Bedingung zu haben.
- Das simulierte Netz wird normalerweise zunächst mit zufälligen Gewichtswerten gefüllt. Es wird nicht gelöscht, denn wenn alle Gewichte (Multiplikatoren) Null sind, ändert sich nichts, wenn das Training beginnt!
- Das Trainingsprogramm gibt einen Satz von Eingabedaten an den CNN-Eingang weiter, führt die Simulation durch und prüft, ob die Ausgabe mit der markierten (richtigen) Antwort übereinstimmt. Ist dies nicht der Fall, werden die Gewichte angepasst und das Netzwerk erneut ausgeführt. Gegebenenfalls wird dieser Vorgang so lange wiederholt, bis sich das Netz auf die richtige Antwort „geeinigt“ hat. Dies ist eine starke Vereinfachung, aber es beschreibt im Großen und Ganzen den als Backpropagation bekannten Lernprozess.
In der Praxis kann der Trainingsprozess viel Zeit in Anspruch nehmen, und der Mensch muss häufig eingreifen, um die Parameter zu verändern, bis das Netz akzeptable Ergebnisse liefert. Um es richtig zu testen, werden neue Eingangsdaten, die nicht zum Trainieren des Netzes verwendet wurden, in der Simulation durchlaufen. Das sollte ausreichen, um zu überprüfen, ob ein TinyML-Netz „intelligent“ genug für diese Aufgabe ist. Diejenigen, die an der Objekterkennung für autonome Fahrzeuge arbeiten, haben festgestellt, dass ein System, das im Labor eine Genauigkeit von etwa 95 % erreicht, auf der Straße nicht besser als mit 50 % abschneidet. Es scheint, dass man zumindest für diese Anwendung nie genug Trainingsdaten hat.
Ableitung eines Ergebnisses
Nach dem „Training“ beginnt die „Inferencing“-Phase, in der dem Netz Live-Daten gezeigt werden und es nach Mustern sucht, die mit den durch das Training erzeugten übereinstimmen. Die Ergebnisse werden nicht berechnet, sondern abgeleitet und als Wahrscheinlichkeit für eine Übereinstimmung dargestellt. Wenn alles in der Simulation funktioniert, kann das Netzwerk in den Speicher des eingebetteten Mikrocontrollers geflasht und in einem Echtzeitsystem getestet werden.
Betrug, Voreingenommenheit und Einsicht
Obwohl sie nicht mit den Fähigkeiten eines natürlichen Gehirns vergleichbar sind, können CNNs Verhaltensweisen an den Tag legen, die auf den ersten Blick etwas beunruhigend erscheinen mögen. Erstens können sie „in der Schule schummeln“, indem sie die „richtige“ Antwort geben, aber aus den falschen Gründen. Das kann passieren, wenn die Trainingsdaten nicht abwechslungsreich genug sind. Ein Lagerroboter kann zum Beispiel darauf trainiert werden, grüne Kartons zu erkennen. Die Trainingsmenge enthält also Bilder aller Formen und Größen der grünen Box. Bei seinem ersten Einsatz greift der Roboter nach einem menschlichen Lagerarbeiter. Warum? Weil er oder sie einen grünen Overall trägt. Während des Trainings „schlussfolgerte“ das Netz, dass alles, was grün gefärbt ist, ein Kasten sein muss - eine nette „Abkürzung“, aber potenziell tödlich. Zweitens kann die Maschine aus ähnlichen Gründen ein verzerrtes Ergebnis liefern. Dies geschah mit Strafregisterdatenbanken, die mit einer nicht repräsentativen Anzahl von schwarzen Personen gefüllt waren. Drittens schließlich ein positives Merkmal: Einsicht. CNNs sind sehr gut im Erkennen von Mustern in großen Datenmengen, die dem menschlichen Gehirn entgehen: Sie erkennen subtile Verhaltensmuster, die zum Beispiel einen Serienmörder in einer riesigen Polizeidatenbank identifizieren könnten. Oder das Aufspüren neuer Gesundheitstrends in einer großen Bevölkerung durch die Analyse von (anonymisierten) Daten von Fitnessuhren.
Fazit
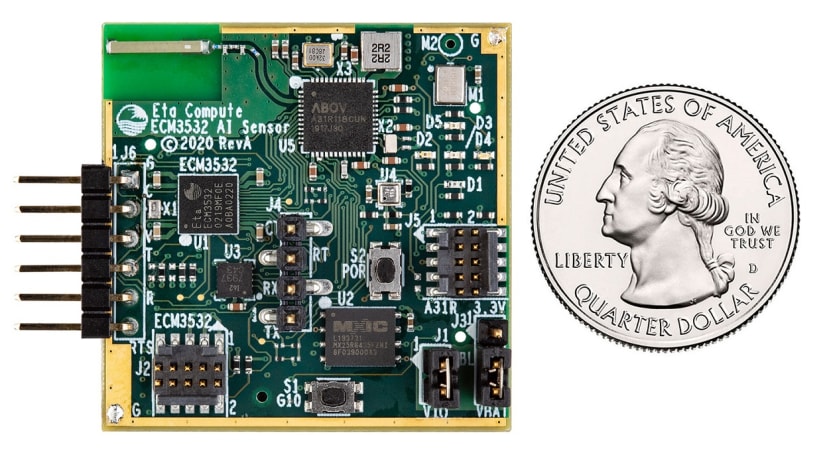
Massive künstliche neuronale Netze, die auf Supercomputern laufen, können für Schlagzeilen sorgen, wenn sie Menschen bei Brettspielen wie Schach und Go schlagen. Viel kleinere TinyML-Netzwerke haben vielleicht nicht den offensichtlichen Einblick, um Spiele zu spielen oder neue Entdeckungen in Wissenschaft und Medizin zu machen, aber sie können das Leben eines Menschen retten oder eine kranke Maschine erkennen, indem sie einige einfache Schlussfolgerungen auf der Grundlage von Sensoreingaben ziehen. Es ist auch weniger wahrscheinlich, dass sie katastrophale Schlüsse ziehen, z. B., dass sie einen Sattelschlepper, der vor ihrem Auto über die Straße fährt, mit einer Brücke verwechseln, die über die Straße führt. Eine Menge neuer Hardware erscheint, die genau auf den TinyML/Edge-Computing-Markt abzielt, von dem jeder glaubt, dass er das nächste große Ding sein wird. Der ECM3532-Chip von Eta Compute (siehe Titelbild) ist für eingebettete KI konzipiert und basiert auf einem ARM Cortex-M3-Kern, der mit einem DSP-Kern von NXP zusammenarbeitet. Ein weiteres neues Gerät, GAP 9 von Greenwaves Technologies, das auf denselben Markt abzielt, enthält einen Cluster von zehn Kernen mit einer RISC-V-Architektur. Beide Unternehmen bieten auch eine vollständige Toolchain für die Entwicklung von KI-Anwendungen mit ihren Produkten an. Erwarten Sie, dass im nächsten Jahr eine ganze Reihe von Mikrocontroller-Chips auf den Markt kommen, die für TinyML optimiert sind. In Zukunft wird KI wahrscheinlich das Internet der Dinge dominieren. Aber nicht die Menscheit, noch nicht ...
Wenn Sie nicht weiterkommen, folgen Sie meinen Beiträgen auf X. Ich verlinke auf interessante Artikel über neue Elektronik und verwandte Technologien und retweete Beiträge, die ich über Roboter, Weltraumforschung und andere Themen entdecke.
Kommentare